프리미엄
투자가설
투자분석
아카데미
커뮤니티
Valley AI 시작하기시작하기
Valley Space인기
내러티브&넘버스를 읽고
wong독서

내러티브&넘버스를 읽고

avatar
Wong
2026.06.11조회수 61회
avatar
Wong
구독자 23명구독중 6명
안녕하세요. 개발과 경제에 관심있는 ADAS 연구원입니다. https://github.com/Wong-Woo
댓글 0개


image.png

밸리AI 플랫폼에서 활동하고 있는 사람이라면 모두가 알 만한 사람, 에스워드 다모다란 교수님의 책 '내러티브&넘버스'를 읽었다.


이 책은 숫자와 이야기(내러티브)를 잘 엮어 나아가야지만 기업의 가치를 잘 계산할 수 있다는 것을 전하고 있다. 다모다란 교수는 이와 함께


  • 숫자, 혹은 이야기에만 치중한 가치 계산의 치명적 위험성

  • (본인만의) 숫자와 스토리를 엮는 방법과 주의점, 그리고 예시

  • 현금흐름 할인법을 제대로 사용하는 방법

  • 등등..


을 소개하는데 내가 느끼기에 이 책의 핵심은 이랬다.


  • 내러티브와 숫자를 엮을 수 있는 방법은 얼마든지 존재하고 그래야만 한다

  • 어떤 프레임으로 투자를 하든지 간에 장단점과 특징을 기초부터 파악해라

  • 편향되는것을 주의해라


엄청나게 일반화했지만.. 정말 정교하고 잘 구조화된, 올바른 기업평가 방법(거의 정답에 가까운 방법)을 이 책에서는 소개하고 있다. 아직 읽어보지 않으셨다면 꼭 한번 읽어보시기를 추천드린다. (이 플랫폼 곳곳과 컨텐츠들이 이 책에서 소개하는 방법과 얼마나 비슷한지 떠오를 것이다!)

회원가입만 해도
이 글을 무료로 읽을 수 있어요.

Basic 7일 무료 체험 시작하기
이미 계정이 있으신가요?로그인하기
아직 작성된 댓글이 없습니다.
독서 카테고리의 다른글

단단한 머신러닝 8 앙상블 학습(markdown)

# 객체와 앙상블 앙상블 학습은 다수의 학습기를 생성하고 결합해서 학습을 시도하는 방법이다. 아래와 같은 구조를 갖고 있다. 여기서 같은 형태의 학습기만 있다면 동질적(homogeneous)이라고 하며, 서로 다른 형태의 객체 학습기로 이루어진 앙상블은 이질적(heterogeneous) 앙상블이라고 부른다. 일반적으로 앙상블 학습은 다수의 학습기가 결합해 단일 학습기보다 우수한 일반화 성능을 얻는다. 약한 학습기(일반화 성능이 랜덤 예측 학습기보다 조금 더 나은 학습기)를 통해 이론적으로는 증명되지만, 현실에서는 여러가지 이유로 그렇지 못한 경우도 종종 있다. <aside> 💡 위 그림에서 ✓는 정확한 분류를, X는 잘못 분류되었다는 것을 뜻하고 앙상블 학습의 결과는 다수결 투표 방법을 통해 생성된다. 여기서 알 수 있는 것은 다음과 같다. **좋은 앙상블 모델을 얻고 싶다면 객체 학습기는 최대한 좋은 성능을 갖는 동시에 다양해야 한다.** </aside> ## 객체 학습기의 수와 오차율 객체 학습기의 수와 오차율 사이에는 어떤 상관관계가 있을까? 이진 분류 문제를 가정하고 정의해보자. $$ P(h_i(x) \neq f(x)) = \epsilon. $$ 여기서 f(x)가 학습하고자 하는 함수이고 h_i(x)가 객체 학습기이다. 만약 앙상블이 간단한 투표 방법으로 T개의 객체 학습기를 결합하고 과반수 이상의 정답을 맞히면 앙상블 분류기가 정답을 맞혔다고 가정하자. $$ H(x) = \text{sign} \left( \sum_{i=1}^{T} h_i(x) \right). $$ 만약 기초 분류기의 오차율이 서로 독립적이라면, Hoeffding 부등식에 의해 앙상블 오차율은 다음과 같다. $$ \begin{align*}P(H(\mathbf{x}) \neq f(\mathbf{x})) &= \sum_{k=0}^{\lfloor T/2 \rfloor} \binom{T}{k} (1-\epsilon)^k \epsilon^{T-k} \\&\leq \exp \left( -\frac{1}{2} T (1 - 2\epsilon)^2 \right)\end{align*} $$ 위 식에서 알 수 있듯, 앙상블 내의 객체 분류기 수 T가 증가할수록 앙상블의 오차율은 기하급수적으로 하락하고 최종적으로는 0에 가까워진다. 하지만 위 관계는 객체 학습기가 서로 독립적이라는 가정을 바탕으로 하고 있기 때문에, 현실과는 큰 괴리가 있다. (실제로 객체 학습기는 같은 문제를 해결하기 위해 해결되므로 결코 상호 독립적일 수 없다) 사실상 객체 학습기의 정확성과 독립성은 근본적으로 모순되기 때문에, 매우 높은 정확도를 달성한 후 다양성을 늘리려 한다면 정확성이 희생되어야할 수 밖에 없다. <aside> 💡 결국 좋지만 다른 객체학습기를 어떻게 생성하고 결합하느냐가 앙상블 학습의 핵심이다. </aside> 현재 앙상블 학습법은 객체 학습기의 생성 방식을 기준으로 크게 두 가지로 나뉜다. - serialization : 객체 학습기 간 강한 의존관계가 있어 연속적으로 생성되는 방법 - **boosting** - parrelization : 객체 학습기 간 의존관계가 약하고 동시 생성이 가능한 방법 - bagging - **random forest** # 부스팅 부스팅은 약한 학습기를 강한 학습기로 향상할 수 있는 알고리즘 계열을 의미한다. 이러한 알고리즘 계열의 작동 메커니즘은 서로 유사하다. 1. 초기 훈련 세트로부터 객체 학습기 훈련 2. 객체 학습기가 학습한 표현을 기반으로 훈련 샘플 분포 조정 (이때 학습기에서 오류를 범했던 훈련 샘플에 대해 조정) 3. 조정 후의 샘플 분포를 기반으로 다음 학습기 훈련 ## AdaBoost 이러한 알고리즘 중 가장 유명한 것은 AdasBoost이다. 다음과 같은 객체 학습기의 선형 조합에서 $$ H(x) = \sum_{t=1}^{T} \alpha_t h_t(x) $$ 다음처럼 정의된 지수 손실함수를 최소화 하는 알고리즘이다. $$ \ell_{\text{exp}} (H | \mathcal{D}) = \mathbb{E}_{\mathbf{x} \sim D} \left[ e^{-f(\mathbf{x})H(\mathbf{x})} \right] $$ 알고리즘은 다음과 같다. 입력: - 훈련 세트 $D = \{(\mathbf{x}_1, y_1), (\mathbf{x}_2, y_2), \dots, (\mathbf{x}_m, y_m)\}$ - 기초 학습 알고리즘 $\mathfrak{L}$ - 훈련 횟수 $T$ 과정: 1. 초기 가중치 분포 설정 $\mathcal{D}_1(\mathbf{x}) = 1/m$ 2. 반복 학습 ($t = 1$ to $T$): - 기초 학습기 훈련: 가중치 분포 $\mathcal{D}_t$를 사용하여 학습 진행 $h_t = \mathfrak{L}(D, \mathcal{D}_t)$ - 오차율 계산: 현재 분포 $\mathcal{D}t$*에서의 예측 실패 확률 $\epsilon_t = P{\mathbf{x} \sim \mathcal{D}_t}(h_t(\mathbf{x}) \neq f(\mathbf{x}))$* - 조기 종료 조건: 오차율이 0.5를 초과하면 중단 `if` $\epsilon_t > 0.5$ `then break` - 학습기 가중치($\alpha_t$) 결정: $\alpha_t = \frac{1}{2} \ln \left( \frac{1-\epsilon_t}{\epsilon_t} \right)$ - 데이터 가중치($\mathcal{D}_{t+1}$) 업데이트: $\mathcal{D}_{t+1}(\mathbf{x}) = \frac{\mathcal{D}_t(\mathbf{x}) \exp(-\alpha_t f(\mathbf{x}) h_t(\mathbf{x}))}{Z_t}$ 3. 최종 모델 출력 (가중치 투표) $H(\mathbf{x}) = \text{sign} \left( \sum_{t=1}^{T} \alpha_t h_t(\mathbf{x}) \right)$ - $\alpha_t$: 해당 학습기가 전체 결과에 얼마나 기여할지 결정합니다. 오차율($\epsilon_t$)이 0에 가까울수록 $\alpha_t$는 무한대로 커집니다. - $\mathcal{D}_{t+1}$: 이전 단계에서 틀린 샘플은 $\exp(\alpha_t)$가 곱해져 가중치가 커지고, 맞은 샘플은 $\exp(-\alpha_t)$가 곱해져 작아집니다. <aside> 💡 AdaBoost 알고리즘은 지수손실함수를 최소화하는 방향으로 동작한다. 만약 H(x)가 지수 손실 함수를 최소화할 수 있다면, $$ \frac{\partial \ell_{\exp}(H \mid \mathcal{D})}{\partial H(x)} = -e^{-H(x)} P(f(\boldsymbol{x}) = 1 \mid \boldsymbol{x}) + e^{H(x)} P(f(\boldsymbol{x}) = -1 \mid \boldsymbol{x}) $$ 이고, 좌변을 0으로 만들면 $$ H(x) = \frac{1}{2} \ln \left( \frac{P(f(x) = 1 \mid x)}{P(f(x) = -1 \mid x)} \right) $$ 이다. 따라서, $$ \begin{align*}\text{sign}(H(\mathbf{x})) &= \text{sign}\left(\frac{1}{2}\ln\frac{P(f(\mathbf{x})=1|\mathbf{x})}{P(f(\mathbf{x})=-1|\mathbf{x})}\right) \\&= \begin{cases}1, & P(f(\mathbf{x})=1|\mathbf{x}) > P(f(\mathbf{x})=-1|\mathbf{x}) \\-1, & P(f(\mathbf{x})=1|\mathbf{x}) < P(f(\mathbf{x})=-1|\mathbf{x})\end{cases} \\&= \operatorname*{arg\,max}_{y \in \{-1,1\}} ...
독서
2026. 01. 31
2
0
38
단단한 머신러닝 8 앙상블 학습(markdown)

단단한 머신러닝 4 의사결정트리(markdown)

이론 정리는 다했는데, 수식때문에 포스팅 진도가 안나가네요.. 불가피하게 md로 올립니다. # **기본 프로세스** 의사결정 트리는 자주 사용되는 머신러닝 학습법 중 하나이다. 이름 그대로 트리 구조에 기반하여 결정한다. 일반적으로 하나의 루트노드를 가지고, 여러개의 내부 노드와 여러개의 리프 노드를 가진다. 리프 노드는 결정 결과에 상응하고, 가타 다른 노드들은 하나의 속성 테스트를 구현한다. 샘플 집합은 루트노드에서 시작해 각 테스트 결과에 따라 하위 노드로 분류된다. 의사결정 트리의 학습 목표는 일반화 성능이 뒤어난 트리를 얻는 것이다. 기본적인 프로세스는 재귀적으로 간단하고 직관적인 분할 정복 전략을 기본으로 한다. 다음과 같은 속성집합 A를 갖는 훈련 세트 D로부터, - 훈련 세트 $D = \{(\boldsymbol{x}_1, y_1), (\boldsymbol{x}_2, y_2), \dots, (\boldsymbol{x}_m, y_m)\}$ - 속성 집합 $A = \{a_1, a_2, \dots, a_d\}$ 기본적인 의사결정트리 의사코드는 다음과 같다. ``` TreeGenerate(D, A) 1: node 생성 2: if $D$의 샘플이 모두 같은 클래스 $C$에 속하면 then 3: 해당 node를 레이블이 $C$인 터미널 노드로 정한다 return 4: end if 5: if $A = \emptyset \space or \space D$의 샘플이 $A$ 속성에 같은 값을 취한다면 then 6: 해당 node를 터미널 노드로 정하고, 해당 클래스는 $D$ 샘플 중 가장 많은 샘플의 수가 속한 속성으로 정한다 return 7: end if 8: $A$에서 최적의 분할 속성 $a_*$를 선택한다 9: for $a_*$의 각 값 $a_*^v$에 대해 다음을 행한다 do 10: node에서 하나의 가지를 생성한다. $D_v$는 $D$는 $a_*^v$ 속성값을 가지는 샘플의 하위 집합으로 표기한다 11: if $D_v$가 $\emptyset$ 이면 then 12: 해당 가지 node를 터미널 노드로 정하고, 해당 클래스는 $D$ ...
독서
2026. 01. 31
3
0

단단한 머신러닝 3 선형모델

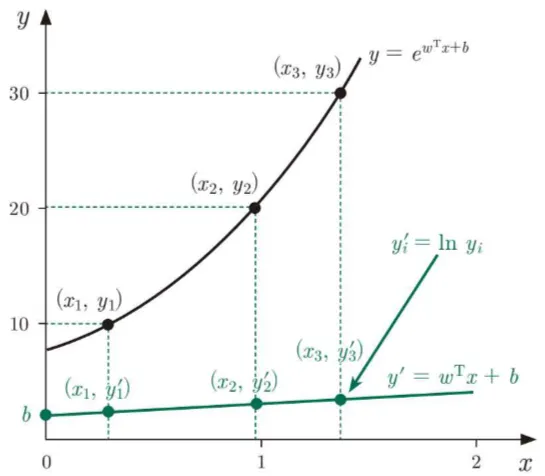
이번 장에서는 몇가지 고전적이지만 중요한 선형 방법을 소개한다. 기본 형식 선형 모델은 형식이 매우 간단하고 모델을 만들기 쉽지만, 머신러닝의 중요한 기본 사상을 담고 있다. 수많은 강력한 성능을 가진 비선형 모델들은 선형 모델을 기반으로 하여 층을 쌓아 올리거나 고차원으로 투영하여 만들기 때문이다. 선형 모델의 w는 예측에 있어서 각 속성의 중요성을 직관적으로 드러내는데, 이를 해석력이 뛰어나다고 표현한다. 선형 회귀 선형 회귀는 데이터를 선형으로 예측하는 것을 목표로 하는 모델이다. 여기서 데이터 세트: 로 정의한다. 먼저 입력 속성이 하나뿐인 가장 간단한 상황을 고려해보자. 선형 회귀는 다음과 같은 함수를 학습한다. 위 식에서 w와 b는 f(x)와 y를 어떻게 측정하느냐에 따라 달렸다. 이전 장에서 소개했듯이, 평균 제곱 오차를 사용할 수 있다. 이를 만족하는 w, b는 으로부터 좌항을 0으로 만들어 인 w, b를 찾는 다는 의미다. (여기서 이다) 이러한 방식을 최소제곱법이라고 부른다. 선형 회귀에서 최소제곱법은 샘플과 유클리드 거리의 합이 최소가 되는 직선을 찾는 것을 목표로 한다. 일반적으로는 d개의 속성을 가진 샘플 데이터 세트 D에 대해 학습시키는 것인데, 이 경우 이를 다항 선형 회귀라 하고 비슷하게 최소제곱법을 이용하여 w와 b를 추정할 수 있다. 다음처럼 정의하자. 그러면, 이고, 오차는 다음처럼 정의된다. 여기서 최적의 w,b 행렬은 다음의 식을 이용해야 한다. 위 식이 단순히 0이 되도록 설정하면 최적 해의 닫힌 해를 구할 수 있다. 하지만 역행렬을 계산해야 하므로 단일 변수일 때보다 많이 복잡하다. 가 full-rank matrix이거나 positive definite matrix일 때 위 식을 0으로 만들어 다음과 같이 계산할 수 있다. 정사각 행렬인 경우 full-rank matrix가 존재한다는 말은 역행렬이 존재한다는 의미이다. 또한 full-rank인 경우여야 피처간 종속성이 사라지기 때문에 학습에 중요한 역할을 할 수 있다. 정치 행렬인 경우여야 space에서 아래로 볼록한 형상이 ...
독서
2026. 01. 31
2
0

[BOOK] 단단한 머신러닝 2 (모델 평가 및 선택)

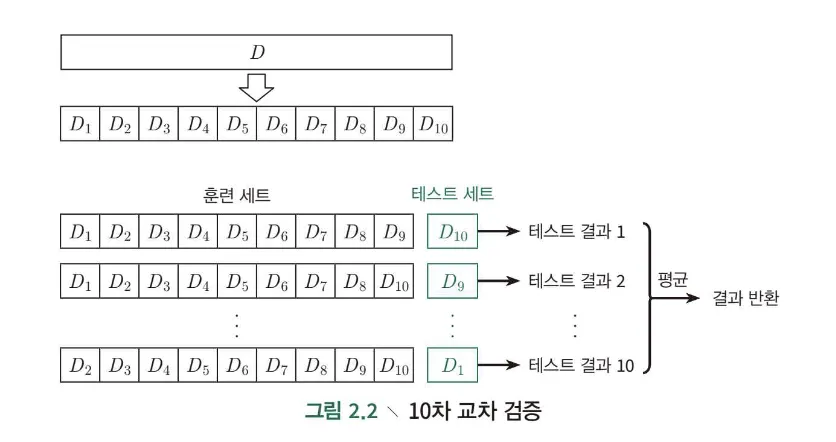
머신러닝의 궁극적인 목적은 주어진 데이터를 통해 패턴을 학습하고, 이를 바탕으로 미지의 데이터에 대해 정확한 예측을 수행하는 것이다. 이때 우리가 만든 모델이 얼마나 우수한지를 판단하기 위해서는 객관적인 평가 기준이 필요하다. 경험 오차 및 과적합 가장 먼저 고려해야할 지표는 오차율이다. 오차율은 모델이 전체 데이터를 판단했을 때 얼마나 실수를 했는지에 대한 비율이다. m: 전체 샘플 수 a: 잘못 분류한 샘플 수 💡이와 반대되는 개념으로 정확도가 있다. 모델이 정답을 맞힌 비율(1-E)을 계산한다. 그 다음, 샘플 값 자체와 실제 예측 값 사이의 오차가 있을 수 있다. 학습기가 훈련 세트상에서 만들어낸 오차를 훈련 오차, 혹은 경험 오차라고 부르며, 학습기와 새로운 샘플 사이의 오차는 일반화 오차라고 한다. 대개 우리는 일반화 오차가 가장 적은 학습기를 원하게 된다. 그러나 학습기가 훈련 데이터에서 학습을 과도하게 잘하면 모든 훈련 데이터의 특성을 일반적인 성질이라 오해하게 되고, 결국 모델이 과적합으로 빠지게 된다. 이와 반대되는 개념으로는 훈련이 덜 된, 과소적합이 있다. 테스트 기법 앞서 말했듯, 우리는 훈련이라는 과정을 통해 학습기의 일반화 오차에 대해 평가를 진행하고 모델을 선택해야한다. 일반화 오차와 그냥 오차를 구분해서 과소적합, 과적합을 회피할 수 있는 방법에는 무엇이 있을까? 바로 데이터 세트를 훈련 세트와 테스트 세트로 구분하는 것이다. 홀드아웃 홀드아웃은 데이터세트 D를 겹치지 않는 두 집합 훈련 세트 집합 S와 테스트 세트 집합T로 나눈다. 주의해야할 점은 데이터 분포인데, 훈련 세트와 테스트 세트의 데이터 분포가 같도록 나눠야 한다는 점이다. 이러한 분류 작업을 층화 추출법 이라고 한다. 이 외에도 중요한 것은 데이터 수의 비율이다. 훈련 세트가 너무 많으면 전체 데이터로 학습한 모델과 비슷해진다는 장점이 있지만, 테스트 데이터가 부족해 평가 결과가 불안정해질 수 있다. 반대로 테스트 세트가 너무 많을 땐 평가가 안정적이지만 학습 데이터가 부족해 실제 전체 데이터로 학습했을 때의 성능과 차이가 커진다. 이 문제에 완벽한 정답은 없지만, 휴리스틱한 관점에서 다음과 같은 비율을 많이 사용한다. 훈련 세트: 전체의 2/3 ~ 4/5 테스트 세트: 전체의 1/5 ~ 1/3 교차 검증 교차검증은 다음과 같은 방법을 k번 반복해서, k개의 테스트 결과값을들 평균 내어 최종 성능으로 사용하는 검증 방법이다. 데이터세트를 층화 추출법으로 k개의 서로소 집합으로 나눈다. k-1개의 조각으로 모델을 학습시키고, 나머지 1개의 조각으로 성능을 테스트한다. 주의사항 데이터를 나누는 과정에서 편향이 발생할 수 있으므로, 데이터를 랜덤하게 섞고 나누는 과정을 반복한다. (즉, fully 교차검증을 n번 시행하되, 매번 데이터를 랜덤하게 섞어서 실행하고 이 결과를 최종 평균함) 일반적으로 10차 10겹 교차검증을 주로 사용함 교차 검증 방법의 변형인 LOOCV라는 방법도 있다. 1개의 관측값을 제외하고 나머지는 모두 훈련 데이터 세트로 사용하는 방법 Bootstrap 부트스트랩은 이러한 LOOCV의 단점을 보완해 줄 수 있는 샘플링 기법이다. 데이터 세트 D로부터 샘플링을 통해 데이터 세트 D'을 만든다. 이 과정을 m번 반복한다. m개의 D' 데이터 세트로 훈련을 시킨다. D'에 한번도 뽑히지 않은 데이터의 집합을 테스트 세트로 활용한다. m번의 샘플링 과정 중 샘플이 한 번도 뽑히지 않을 확률은 다음과 같다. 즉, 부트스트랩을 사용하면 데이터 세트 D 중 36.8%의 샘플은 D'에 샘플링되지 못하고 테스트세트로 활용할 수 있다. 💡OOB 샘플이란 부트스트랩 샘플링 중 나머지(Out of Bag)를 가지고 테스트 세트로 활용하는 것 처럼 모델의 성능을 별도의 검증 데이터셋 없이 추정하는데 사용하는 기법이다. 모델 성능 측정 이 절에서는 학습기의 일반화 성능에 대해 평가하기 위해 사용하는 다양한 지표에 대해 알아본다. 모델의 좋고 나쁨을 결정하는 것은 알고리즘과 데이터가 아닌 데이터 분석 목적(정답 데이터)에 달렸다. 예측을 위해 사용하는 데이터 샘플 D가 아래와 같이 있다면, 정답 데이터인 y_i와 예측 결과인 f(x_i)를 비교해야 한다. 평균 제곱 오차 회귀분석에서 가장 자주 사용하는 성능 측정 방법이다. (연속확률 분포에 대한 정의)더 일반적으로 표현하면 다음과 같다. 오차율과 정확도 오차율 정확도 F-1 스코어 오차율과 정확도는 자주 사용되지만 한계가 있다. 분류 결과 혼동행렬을 시각화 해보면, 오차율과 정확도 뿐만 아니라 정밀도와 재현율이 중요하다는 점을 알 수 있다. 정밀도P와 재현율R은 다음처럼 정의된다. 일반적으로 정밀도와 재현율은 트레이드오프 관계이다....

[BOOK] 단단한 머신러닝 1

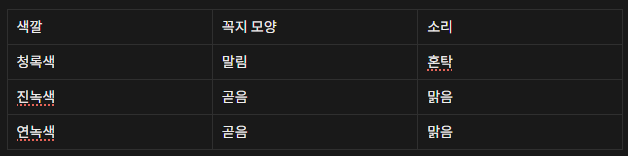
머신러닝은 컴퓨터라는 도구로 하여금 경험을 활용해 시스템 자체를 개선해 나가는 학문이다. 컴퓨터 시스템에서 일반적으로 경험은 데이터라는 형식으로 존재하고, 따라서 머신러닝이 연구하는 주요 내용은 학습 알고리즘, 즉 컴퓨터를 활용해 데이터에서 하나의 모델(이 책에서 사용하는 ‘모델’은 데이터를 통해 학습한 결과를 뜻한다)을 만들어내는 알고리즘이라 할 수 있다. 머신러닝의 기본 용어 잘 익은 수박을 고르는 상황을 가정하자. 줄이 선명한 수박을 찾아 두드려 보고, 청명한 소리가 나는지 이것저것 확인해 본다. 세개 정도 확인해 보니 다음과 같은 수박이 있다고 기록했다. 이 표를 통해 머신러닝에서 쓰이는 용어들을 정의할 수 있는데, 다음과 같다. 데이터셋 관련 용어 data set: 모든 기록의 집합 sample(instance): 표의 행(하나의 수박에 대한 기록) attribute(feature): 열의 제목(수박의 속성) attribute value: 청록색, 곧음 등의 속성을 나타내는 값 attribute space: 각 열에 대한 1차원 공간 sample space: 각 열로 이루어진 n(여기서는 3)차원 공간 dimensionality: 열의 개수 feature vector: 샘플이 샘플 공간에서 표현된 벡터 데이터셋 관련 수학적 표현 m개의 샘플을 가진 데이터 세트 샘플 x_i는 d차원 샘플공간 X위 하나의 벡터이다. x_{ij}는 i번째 샘플의 j번째 속성값이다. 학습 관련 용어 learning(training): 데이터를 통해 모델을 만들어 가는 과정 training data(training set): 훈련 과정에서 사용된 데이터(데이터셋) training sample: 훈련 과정에서 사용된 데이터 중 하나의 샘플 hypothesis: 훈련된 모델이 따른다고 제기되는 규칙 ground truth: 훈련된 모델이 따른다고 확인된 규칙 learner(학습기): 모델의 또다른 방언 prediction: 훈련 과정에서 사용되지 않은 데이터를 모델에 입력했을 때 나오는 결과 ...
독서
2026. 01. 08
2
1
35
단단한 머신러닝 4 의사결정트리(markdown)
23
단단한 머신러닝 3 선형모델
독서
2026. 01. 16
2
0
39
[BOOK] 단단한 머신러닝 2 (모델 평가 및 선택)
65
[BOOK] 단단한 머신러닝 1